텐센트, AI 에이전트가 학습시킨 단백질 모델 배포
편집·검토: AI Ping 편집팀
3줄 요약
- 하이라2.0 성과물의 가중치·추론 코드가 11월 2일 공개됐다.
- 단백질 설계·서열 분석과 분자 시뮬레이션에 적용할 수 있다.
- 보고된 속도는 H20 시험 조건에 따른 회사 측 수치다.

텐센트 혼위안이 AI 연구 에이전트 ‘하이라2.0’으로 학습시킨 단백질 모델의 가중치와 추론 코드를 공개했다. 11월 2일 공식 연구 저장소에 등록한 배포 자료에는 단백질 서열을 설계하는 모델과 서열의 특성을 분석하는 모델, 분자 운동을 계산하는 모델군이 담겼다.
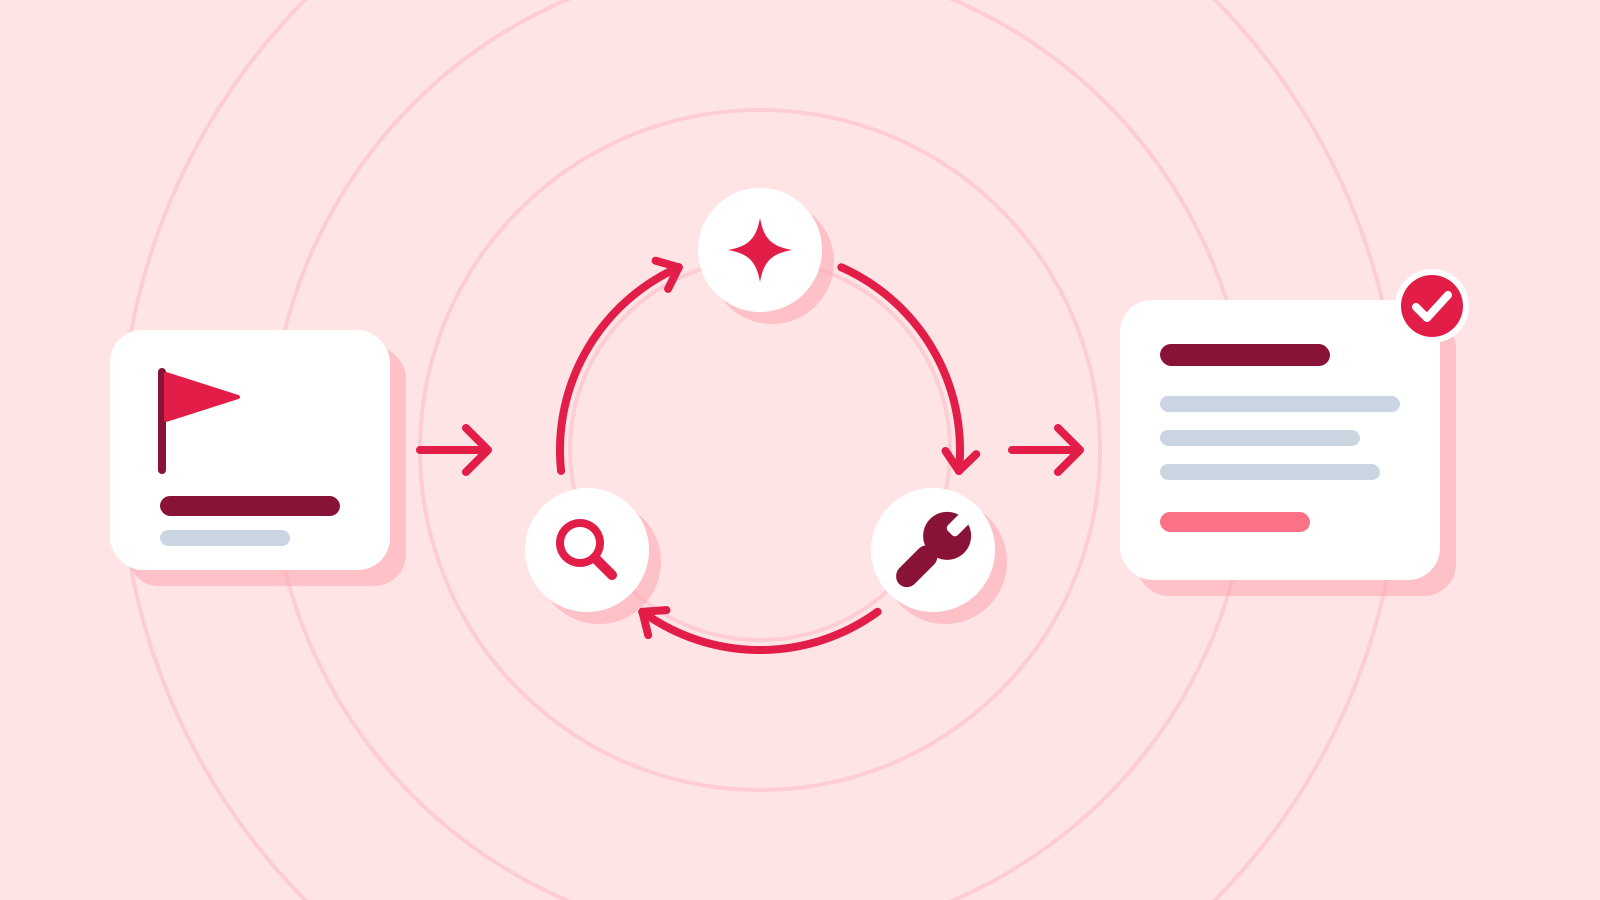
외부 연구자는 이 성과물을 내려받아 자신의 단백질 구조와 서열, 분자 자료에 적용할 수 있게 됐다. 텐센트는 하이라2.0의 연구 과정에서 실험 기록과 코드 버전을 보존하고, 결론을 따로 검토하는 절차를 둔다고 설명했다. 큰 연산 비용을 쓰는 작업은 사람의 승인을 받는다.
단백질 설계 모델 ‘하이인브(HyInv)’는 목표로 삼은 단백질의 뼈대 구조를 입력받아 아미노산 서열 후보를 만든다. 실험으로 검사할 후보를 여러 개 준비하는 단계에 쓰인다. 약 196만 개의 매개변수를 가진 모델로, 가중치 파일은 7.8MB다. CPU와 GPU에서 실행하며 단백질의 특정 위치를 고정한 채 나머지 서열을 설계할 수 있다.
10월 14일자로 작성된 기술 보고서는 후보를 먼저 생성하고 묶음 단위로 다시 수정하는 방식을 설명한다. 학습에는 예측한 단백질 구조가 입력 뼈대와 얼마나 비슷한지를 보상으로 쓰는 강화학습을 적용했다. 평가는 후보 서열의 다양성과 구조 일치도를 함께 비교했다. 실제 서열을 설계할 때는 뼈대 정보만 입력하며 별도의 단백질 언어모델이나 구조 예측 모델을 실행할 필요가 없다고 보고서는 설명했다. 보고서의 구조 일치도는 별도 예측 모델로 다시 접은 구조를 기준으로 계산한 값이다.

텐센트는 하이인브가 H20 GPU 한 장에서 아미노산 잔기 402개짜리 뼈대의 후보 서열 128개를 50.6밀리초에 생성했다고 보고했다. 잔기는 단백질 사슬을 이루는 아미노산 단위다. 이 수치는 빠른 연산 모드의 결과로 컴파일과 실행 준비 시간을 제외한다. 공개 실행 문서는 빠른 모드가 기본 모드와 수치적으로 다른 경로를 쓰며, 같은 난수 조건에서도 후보 서열이 달라진다고 명시했다.
서열 분석용 ‘하이PLM 플래시’는 단백질 서열의 가려진 아미노산을 복원하도록 학습한 약 6억5천만 매개변수 모델이다. 변이가 단백질 특성에 주는 영향을 점수화하거나 서열의 특징을 수치로 추출하는 데 쓴다. 10월 12일자 보고서에 따르면 학습량은 7,260억 토큰으로, 비교 대상인 ESM-2 650M의 0.73배다. 텐센트는 같은 평가 절차로 28개 공개 체크포인트를 대조해 변이 효과 예측의 상관계수가 비슷한 크기의 주요 모델들과 통계적으로 동률이었다고 밝혔다.
공개된 하이PLM 실행 엔진은 H20 한 장에서 초당 약 13만 잔기를 처리한다고 텐센트는 설명했다. 한 서열은 최대 8,190잔기까지 입력받으며, GPU 실행 환경이 필요하다. 공개 가중치는 2.6GB이며 파일을 나눠 배포한다. 실행 프로그램은 서열의 잔기별 특징과 전체를 요약한 특징을 수치 벡터로 반환할 수 있다. 기본 정밀도는 INT8이다. 서열이 거의 같은 변이체들로 별도의 예측 모델을 학습시키는 경우에는 BF16 정밀도를 쓰도록 문서에 적었다.
함께 배포한 ‘하이FF’는 원자의 종류와 좌표로 에너지와 원자에 작용하는 힘을 예측해 분자 운동을 계산한다. 230만~12억 매개변수의 다섯 크기를 제공하며 83개 원소를 다룬다. 전체 전하와 스핀 상태도 입력할 수 있다. 이 모델군은 양자화학 계산 자료인 OMol25로 학습했다. 크기가 커질수록 정확도와 계산 시간의 관계도 달라진다.

10월 29일자 하이FF 보고서는 276만여 구조의 검증 자료와 H20 한 장에서 원자 2,586개를 움직이는 계산으로 성능을 비교했다. 텐센트가 보고한 중간 크기 모델의 힘 오차는 UMA-S-1.2와 비슷한 수준이었고, 같은 시험의 계산 속도는 29배였다. 문서는 다른 GPU에서의 실행은 아직 검증하지 않았다고 밝혔다. 단일 구조의 에너지·힘 예측은 CPU에서도 가능하지만, 분자 운동 계산과 가속 엔진에는 리눅스·엔비디아 GPU·CUDA 환경이 필요하다. 시뮬레이션은 온도와 압력을 다루는 여러 조건을 지원하고 계산 시간, 에너지 변화, 마지막 원자 좌표를 파일로 남긴다.
단백질 모델 두 종은 각각 MIT 라이선스로, 하이FF는 아파치2.0 라이선스로 배포됐다. 하이FF의 가중치는 패키지와 별도로 제공하며 첫 사용 때 내려받고 해시를 검사한다. 기술 보고서에 적힌 작성일은 10월이지만, 공식 저장소의 가중치·코드 공개 기록은 11월 2일이다.
출처
- Hyra 2.0: The Next Step for Auto Research — Tencent Hunyuan
- November 2 model-release records — Tencent Hunyuan
- HyInv released inference documentation — Tencent Hunyuan
- HyInv Technical Report — October 14, 2026 — Hyra Team
- HyPLM-Flash released inference documentation — Tencent Hunyuan
- HyPLM Technical Report — October 12, 2026 — Hyra Team
- HyFF released execution documentation — Tencent Hunyuan
- HyFF Technical Report — October 29, 2026 — Hyra Team
- HyPLM weights release — November 2, 2026 — Tencent Hunyuan
- HyFF model weights release — November 2, 2026 — Tencent Hunyuan