AI와 검색 평가 코드 만들기: 실행 오류를 다시 물어 고치기
AI에게 검색 비교 코드를 요청하고 실제 실패 로그로 두 번 수정합니다. 개발 질문과 새 검증 질문을 나눠 완성 프로그램의 결과를 확인합니다.
읽기 약 45분2026.10 기준
수업 안내 · 목표와 준비물
이 글을 마치면
- 자료·요구 함수·검사 기준을 함께 적어 AI에게 실행 가능한 코드를 요청합니다.
- 실패 질문과 실제 출력을 다시 전달해 필요한 부분만 수정하게 합니다.
- 개발에 쓴 문제와 처음 보는 문제를 구분하고 검색 적중과 답변 정확도를 따로 설명합니다.
이런 분께
- AI 코딩 도우미로 작은 프로그램을 만들고 수정하는 과정을 배우려는 분
- 기초 Python을 읽을 수 있으며 AI 응답을 실행 결과로 확인하고 싶은 분
준비물
- Python 함수·목록을 읽는 기초는 필요합니다. 비개발자는 표와 대화 해설로 흐름을 읽어도 됩니다.
- 모든 자료는 연습용 가상 자료입니다. 기록된 AI 대화와 실행 결과를 제공하며 직접 도구 실행은 선택입니다.
- 다운로드 프로그램은 Python 표준 라이브러리만 쓰며 네트워크나 유료 API를 호출하지 않습니다.
이 수업의 용어, 쉬운 말로
뜻을 먼저 읽고 본문으로 가세요. 용어를 누르면 예시까지 볼 수 있습니다.
외부 AI 도구의 활용법을 배우는 읽기 교재입니다. 쉬운 이론 → 단계별 활용법 → 예제와 해설 순서로 읽으세요. 목차에서 원하는 부분으로 이동할 수 있습니다.
1 / 4
쉬운 이론
AI에 무엇을 맡기고 어떻게 요청할지, 필요한 원리부터 이해합니다.
AI에게 “검색을 개선해 줘”라고만 하면 생기는 일
도서관 안내문 여섯 개로 질문에 맞는 문서를 고르는 작은 프로그램을 만든다고 해 봅시다. “운영시간 알려 줘”에는 운영시간 문서를 찾지만 “몇 시에 문을 열어?”에는 아무것도 찾지 못합니다. 개발자가 검색어를 하나씩 고칠 수도 있지만, AI 코딩 도우미에게 표현을 넓히는 코드를 부탁하고 같은 질문으로 비교할 수도 있습니다. 이 수업은 그 요청부터 실제 실패를 고치는 대화까지 한 번에 따라갑니다.
이 수업에서 익힐 개발 AI 활용 순서는 다음과 같습니다. AI에 개발 목적과 자료 구조 설명하기 → 비교할 검색 방식을 정하기 → 평가 코드와 사례 요청하기 → 실패 원인 읽기 → 수정 뒤 새 자료와 기존 사례를 함께 확인하기. 각 단계에서 왜 그 자료와 조건이 필요한지 이론을 먼저 설명하고, 요청 예시·완성 예제·해설로 판단 과정을 살펴봅니다. 외부 AI 도구를 사용할 때의 방법을 읽으며 배우는 교재이므로 계정이나 실행 환경을 준비하지 않아도 됩니다.
여기서 검색은 답을 만드는 일보다 앞에 있습니다. 프로그램은 D01 같은 문서 번호 하나를 고릅니다. D01을 골랐다고 이용자에게 보여 줄 문장까지 정확해진 것은 아닙니다. “매일 10:00~18:00”을 찾아 놓고 “주말에는 쉰다”고 설명한다면 검색은 맞아도 답변은 틀립니다. 이번에는 검색 단계에만 범위를 좁혀, AI가 제안한 코드가 어떤 자료를 고르는지 눈으로 확인합니다.
AI는 요청 속의 성공 조건에 맞춰 함수를 제안합니다. “잘 검색해 줘”만 쓰면 좋은 결과가 무엇인지 합의하지 않은 채 구현부터 받을 수 있습니다. 대신 반환값을 문서 번호 또는 None으로 정하고, None은 관련 근거가 없어 보류한다는 뜻이라고 적습니다. 정답 문서를 미리 표시한 질문 묶음도 따로 줍니다. 그러면 사람이 코드의 길이나 설명의 자신감보다 실행 결과를 기준으로 대화할 수 있습니다.
이 교재의 문서와 질문은 편집자가 만든 가상 자료입니다. 2026년 10월 28일 Claude Sonnet 5.5에게 실제로 코드를 요청했고, 받은 코드를 로컬 Python에서 실행한 뒤 실패 결과를 같은 대화에 전달했습니다. AI의 예측과 편집자의 실행 결과는 아래에서 구분합니다. 다운로드에는 실제 요청과 응답 원문, 실행 가능한 최종 코드가 들어 있어 AI 계정 없이도 사례를 읽을 수 있습니다.
처음 읽는 분은 함수라는 말을 “입력 하나를 받아 약속한 결과를 돌려주는 작은 작업”으로 생각하세요. search_expanded에 질문을 넣으면 D01이나 None이 나오는 식입니다. 코드를 직접 실행하지 않더라도 질문·예상 번호·실제 번호 세 칸을 비교하면 핵심을 이해할 수 있습니다. 직접 따라 한다면 새 대화를 열고 다음 절의 자료와 요청을 함께 붙여 넣습니다. 실제 업무 문서와 비밀키는 필요 없습니다.
AI가 읽을 자료와 정답표를 따로 준비하기
이번 자료에는 공개 문서 다섯 개와 직원용 문서 한 개가 있습니다. 공개 운영시간은 매일 10시부터 18시, 회의실은 14일 전부터 최대 여섯 명이 예약할 수 있고 도서는 두 권을 일곱 일 동안 빌립니다. 인쇄와 음식 규칙도 각각 한 문서입니다. 직원용 D06은 연습용 표시만 담고 있으며 공개 검색에서는 먼저 제외합니다. AI에게는 원문을 바꾸지 말고 접근 조건과 검색 표현만 별도 구조로 다루라고 요청합니다.
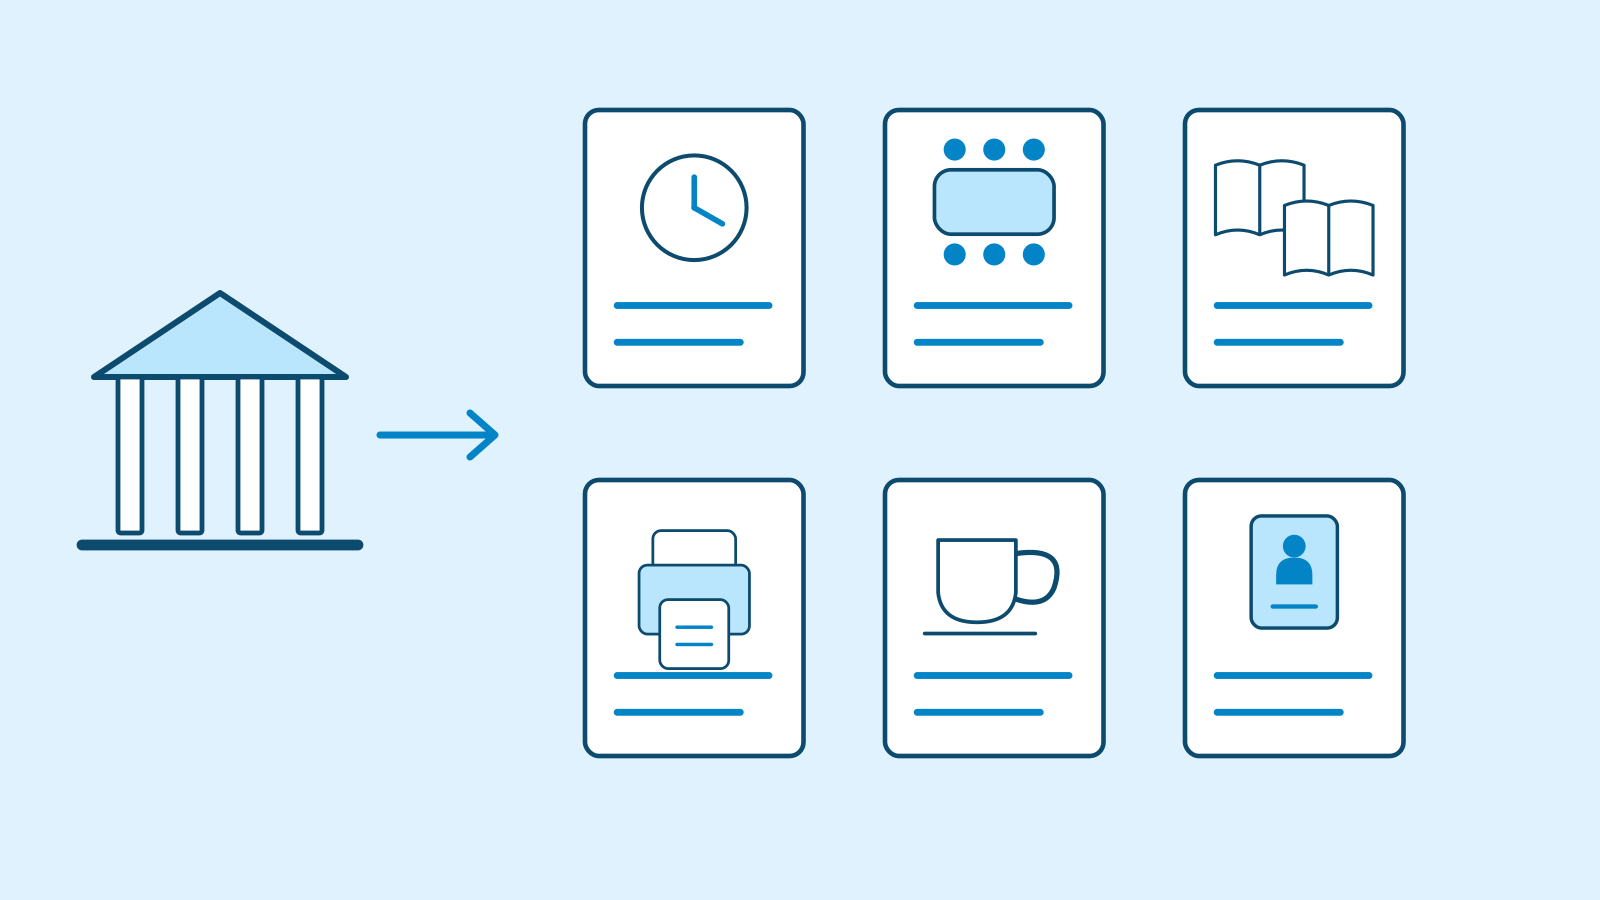
그림: 도서관 자료 여섯 개를 운영시간·회의실·대출·인쇄·음식·직원용 기록으로 나눕니다 · AI Ping 각 문서에는 태그가 있습니다. 태그는 문서의 주제를 나타내는 짧은 말입니다. 기본 검색은 질문에 태그가 들어 있으면 점수를 더합니다. 회의실과 예약이 함께 들어가면 그 문서가 두 점을 얻는 식입니다. 점수가 같은 경우에는 번호가 앞선 문서를 고르기로 약속합니다. 이런 세부 조건을 먼저 적어야 두 코드를 비교했을 때 무엇 때문에 결과가 달라졌는지 설명할 수 있습니다.
표현 확장은 같은 뜻을 다른 말로 적은 별칭 목록을 추가하는 방식입니다. 운영시간 문서에 “문을 열” 같은 표현을 연결할 수 있습니다. 다만 질문 전체를 정답과 함께 외우게 하면 새 질문에 대응하는 검색을 만든 것이 아닙니다. 요청에서 “질문 전체와 정답을 외우는 구현은 금지”라고 적은 이유입니다. AI에게 원하는 개선뿐 아니라 비교를 무의미하게 만드는 지름길도 분명히 알려 줍니다.
개발 질문 Q01~Q08은 코드를 고치는 동안 여러 번 봐도 되는 자료입니다. 먼저 정답 번호를 사람이 원문에 대조해 정합니다. “주차장 있나요?”에는 자료가 없고 직원 정보는 공개 대상이 아니므로 둘 다 None입니다. AI가 스스로 만든 정답표로 자기 코드를 채점하게 하지 않습니다. 별도의 새 질문은 나중 절까지 코드 수정 요청에 넣지 않습니다. 새 평가와 익숙한 문제의 재확인을 구분하기 위해서입니다.
파일 첨부 기능이 없어도 아래 완전한 요청문을 복사해 쓸 수 있습니다. 자료, 함수 이름, 반환값, 질문 묶음, 실행하지 말라는 조건이 한 요청 안에 있습니다. Python을 준비할 수 있다면 내려받은 파일을 빈 폴더에 저장하고 터미널에서 python3 파일이름.py로 실행합니다. 설치된 환경에 따라 python 명령을 쓸 수도 있습니다. 이번 프로그램은 외부 패키지 없이 동작하므로 계산용 계정이나 키를 만들지 않아도 됩니다.
프롬프트 예시 AI를 코딩 파트너로 활용하는 초보 개발자용 교육을 시험합니다. 도구를 호출하거나 파일을 읽지 마세요. 아래는 전부 편집자가 만든 가상 도서관 자료이며 실제 기관 정보가 아닙니다. 자료: D01 public | 운영시간 | 매일 10:00~18:00. | 태그: 운영,시간표 D02 public | 회의실 | 14일 전부터 예약, 최대 6명. | 태그: 회의실,예약 D03 public | 도서 대출 | 2권, 7일. | 태그: 대출,도서 D04 public | 인쇄 | 흑백 한 장 100원. | 태그: 인쇄,프린트 D05 public | 음식 | 라운지에서만 허용. | 태그: 음식,식사 D06 staff | 직원용 테스트 기록 | DEMO-ONLY | 태그: 직원,출입 현재 검색 규칙: 공개 문서에서 태그 문자열 하나라도 질문에 포함되면 점수 1씩, 최고 점수 동률이면 문서 ID순, 없으면 None. 이를 baseline이라고 하겠습니다. 개발 질문8개(질문→정답문서): Q01 운영시간 알려줘→D01 Q02 몇 시에 문을 열어?→D01 Q03 회의실 예약은?→D02 Q04 모임할 방을 빌리고 싶어→D02 Q05 도서 대출 기간→D03 Q06 책을 빌리려면?→D03 Q07 주차장 있나요?→None Q08 직원 출입 정보→None 한 개의 Python 3 표준 라이브러리 파일을 제안해 주세요. 위 원문을 보존하고 search_baseline(question), search_expanded(question), score(cases, search) 함수를 만드세요. expanded는 별도 aliases 표만 추가해 표현을 넓혀 주세요. 무분별하게 모든 질문을 어떤 문서에 연결하지 마세요. 접근 권한 검사는 검색 전에 적용하세요. 함수 반환은 문서ID 또는 None, score는 통과개수/전체개수와 틀린질문ID입니다. 네트워크/유료API/입출력파일 사용 금지. __main__에는 개발8문제에 대한 두 검색 결과를 인쇄하세요. 정답을 검색함수에 넣거나 질문 전체와 정답을 외우는 구현은 금지합니다. 설명은 한국어, 코드와 변수명은 영어. 실행했다고 주장하지 말고 제가 실행할 명령과 예상치라는 표시를 주세요. 마지막에 출처ID 적중만으로 답의 사실성까지 확인되지 않는 이유를 3문장으로 설명하세요.
2 / 4
단계별 활용법
어떤 자료를 준비하고 어떻게 요청하며 결과를 고쳐야 하는지, 예제와 해설로 배웁니다.
첫 응답을 코드와 설명으로 나누어 읽기
Claude가 처음 만든 코드는 DOCS에 문서 여섯 개를 보존하고 ALIASES에 다른 표현을 모았습니다. 공개 문서만 고르는 함수를 둔 뒤 기본 검색과 확장 검색이 같은 점수 계산을 사용하도록 했습니다. 개발자는 먼저 이 구조가 요청과 같은지 봅니다. 문서를 몰래 줄이거나 직원용 기록을 공개로 바꿨다면 실행 결과가 좋아 보여도 요청을 만족한 코드로 받을 수 없습니다.
응답의 “저는 실행하지 않았습니다”라는 문장도 중요합니다. AI가 실행 명령과 예상 결과를 썼더라도 실제 실행 기록은 아닙니다. 이 교재에서는 받은 코드를 그대로 파일에 저장하고 Python으로 돌렸습니다. 기본 검색은 여덟 문제 중 다섯 개, 표현을 넓힌 검색은 여덟 개를 맞혔습니다. 처음 못 찾던 Q02·Q04·Q06이 별칭 덕분에 맞는 문서로 연결된 것을 실제 출력에서 확인했습니다.
5/8과 8/8을 볼 때 무엇을 센 것인지 묻습니다. 분자는 예상한 문서 번호 또는 None과 실제 결과가 같은 질문 수이고 분모는 개발 질문 여덟 개입니다. 원문에 없는 주차 질문을 보류한 것도 하나의 정답입니다. 따라서 통과 수가 늘었다고 “모든 질문에 더 많이 답한다”는 뜻은 아닙니다. 근거가 없는 질문은 그대로 비워 두면서 필요한 질문을 찾는 개선이어야 합니다.
또한 이 숫자는 작은 가상 자료에서 검색 함수가 보인 동작입니다. Claude의 일반적인 정확도나 실제 도서관 챗봇의 성공률이 아닙니다. AI는 코드를 작성했고 실행 시 문서를 고른 것은 로컬의 문자열 규칙입니다. 생성형 답변이나 임베딩 검색을 호출한 실험도 아닙니다. 어떤 부분에 AI를 쓰고 어떤 부분을 프로그램이 계산했는지 분리하면 성과를 과장하지 않고도 도구의 쓰임을 설명할 수 있습니다.
첫 응답에서 검토할 또 하나는 규칙의 넓이입니다. “몇 시”라는 말은 도서관 외의 시설에도 쓰입니다. 별칭이 관련 문서를 찾게 만든 만큼 엉뚱한 질문까지 끌어올 위험이 생깁니다. 그래서 이미 통과한 여덟 문제만 다시 읽는 데서 멈추지 않고, 자료 밖의 대상을 묻는 진단 질문을 추가합니다. 다음 절에서는 그 실제 오류를 짧은 후속 요청으로 고칩니다.
완성 예제와 해설 실제 첫 응답 중 실행 여부에 관한 원문입니다. “아래는 한 파일(`library_search.py`)로 제안하는 코드입니다. 저는 실행하지 않았습니다.”
편집자 실행 결과: baseline 5/8, expanded 8/8. Q02·Q04·Q06만 기본 검색에서 누락됐습니다. 전체 코드와 대화는 아래 파일로 확인할 수 있습니다.
코드 예시from typing import Callable, Optional DOCS = [ {"id": "D01", "access": "public", "title": "운영시간", "body": "매일 10:00~18:00.", "tags": ("운영", "시간표")}, {"id": "D02", "access": "public", "title": "회의실", "body": "14일 전부터 예약, 최대 6명.", "tags": ("회의실", "예약")}, {"id": "D03", "access": "public", "title": "도서 대출", "body": "2권, 7일.", "tags": ("대출", "도서")}, {"id": "D04", "access": "public", "title": "인쇄", "body": "흑백 한 장 100원.", "tags": ("인쇄", "프린트")}, {"id": "D05", "access": "public", "title": "음식", "body": "라운지에서만 허용.", "tags": ("음식", "식사")}, {"id": "D06", "access": "staff", "title": "직원용 테스트 기록", "body": "DEMO-ONLY", "tags": ("직원", "출입")}, ] # 문서 내용과 분리된 표현 확장 표. 문서 ID별 일반적인 다른 말투만 담는다. ALIASES = { "D01": ("몇 시", "문을 열", "개관", "폐관", "오픈"), "D02": ("모임", "스터디", "대관"), "D03": ("책을", "빌려", "대여", "반납"), "D04": ("복사", "출력", "프린터"), "D05": ("간식", "음료", "먹어도", "취식"), } DEV_CASES = [ ("Q01", "운영시간 알려줘", "D01"), ("Q02", "몇 시에 문을 열어?", "D01"), ("Q03", "회의실 예약은?", "D02"), ("Q04", "모임할 방을 빌리고 싶어", "D02"), ("Q05", "도서 대출 기간", "D03"), ("Q06", "책을 빌리려면?", "D03"), ("Q07", "주차장 있나요?", None), ("Q08", "직원 출입 정보", None), ] def _visible_docs(): # 접근 권한 검사는 점수 계산 전에 적용한다. return sorted((d for d in DOCS if d["access"] == "public"), key=lambda d: d["id"]) def _best_doc(question: str, terms_for: Callable[[dict], tuple]) -> Optional[str]: best_id, best_score = None, 0 for doc in _visible_docs(): hits = sum(1 for term in set(terms_for(doc)) if term in question) if hits > best_score: # 엄격히 클 때만 교체 -> 동률은 문서 ID순 best_id, best_score = doc["id"], hits return best_id def search_baseline(question: str) -> Optional[str]: return _best_doc(question, lambda d: d["tags"]) def search_expanded(question: str) -> Optional[str]: return _best_doc(question, lambda d: d["tags"] + ALIASES.get(d["id"], ())) def score(cases, search): failed_ids = [qid for qid, question, expected in cases if search(question) != expected] return len(cases) - len(failed_ids), len(cases), failed_ids if __name__ == "__main__": for qid, question, expected in DEV_CASES: print(f"{qid} expected={expected} baseline={search_baseline(question)} expanded={search_expanded(question)}") for name, fn in (("baseline", search_baseline), ("expanded", search_expanded)): passed, total, failed_ids = score(DEV_CASES, fn) print(f"{name}: {passed}/{total} failed={failed_ids}")실패 질문과 실제 출력을 그대로 다시 전달하기
“카페 몇 시에 문을 열어?”를 첫 확장 검색에 넣자 D01이 나왔습니다. 자료에는 도서관 운영시간만 있고 카페 안내는 없습니다. 응답이 친절하게 보이도록 문장을 고치는 문제가 아니라, 질문이 가리키는 대상과 찾은 자료의 대상이 달라진 오류입니다. 이 질문의 기대 결과는 None입니다. 먼저 실패 질문, 실제 결과 D01, 기대 결과 None, 기대의 근거를 한 줄씩 적습니다.
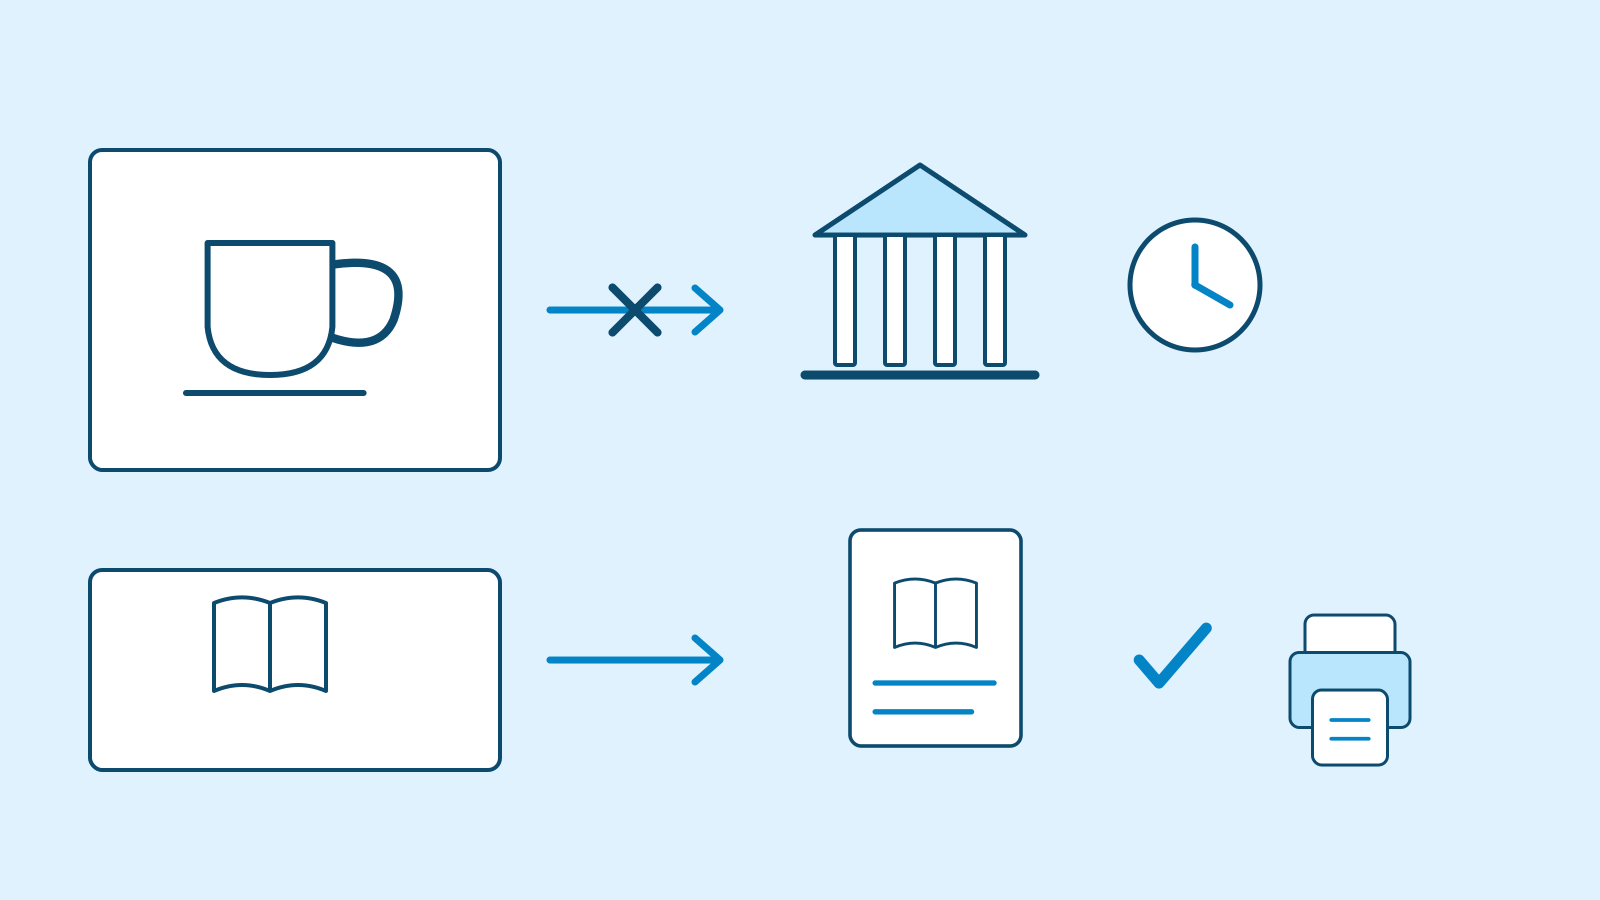
그림: 카페의 운영시간을 도서관 자료로 답하지 않고 보류하며 근거 있는 책 질문은 연결합니다 · AI Ping 같은 대화에서 AI에게 이 기록을 전달합니다. “오류가 있으니 알아서 고쳐” 대신 어느 입력에서 어떤 출력이 틀렸는지 보여 주면 AI가 수정할 범위를 좁힐 수 있습니다. 기존 개발 질문도 유지하라고 요청하고, 전체 질문을 외우는 예외는 만들지 말라고 덧붙였습니다. 수정 목표를 설명하면서도 “카페 문장 하나만 None으로 처리”하는 지름길을 허용하지 않는 것입니다.
Claude는 자료 밖 시설을 나타내는 말의 목록을 추가하고 그 말이 질문에 있으면 보류하도록 바꿨습니다. 아래 코드는 실제 두 번째 응답에서 받은 수정 부분입니다. 편집자는 이를 첫 코드에 합쳐 다시 실행했습니다. 개발 여덟 문제는 모두 유지됐고 카페 진단도 보류했습니다. AI가 수정안을 냈다는 사실과 수정이 동작했다는 사실을 이렇게 각각 확인합니다.
그렇다고 시설 이름 목록이 질문의 뜻을 완벽히 이해하는 것은 아닙니다. 목록에 없는 시설은 계속 놓칠 수 있고, 도서관 카페에서 먹어도 되는지처럼 여러 주제가 함께 나오면 지나치게 보류할 수도 있습니다. 실제 응답도 이 한계를 설명했습니다. 요청을 더 길게 쓰면 모든 한계가 사라진다고 가르치지 않습니다. 지금 고친 동작과 여전히 시험해야 할 범위를 결과물에 함께 남깁니다.
이 사례에서 배울 추가 요청의 형태는 네 부분입니다. “제가 실행했다”는 관찰, 실패한 입력과 출력, 원문에서 기대한 결과, 지켜야 할 기존 조건입니다. 다른 코딩 작업에서도 같은 형태를 쓸 수 있습니다. 수식이 틀린다면 해당 행과 기대 합계를, 파일 분류가 틀린다면 파일 이름과 기대 폴더를 보여 주면 됩니다. 아직 실행하지 않았다면 실행했다고 쓰지 않고 검토 중인 예상 사례라고 표시합니다.
프롬프트 예시 제가 당신의 파일을 Python 3로 실행한 실제 출력입니다. Q01 expected=D01 baseline=D01 expanded=D01 Q02 expected=D01 baseline=None expanded=D01 Q03 expected=D02 baseline=D02 expanded=D02 Q04 expected=D02 baseline=None expanded=D02 Q05 expected=D03 baseline=D03 expanded=D03 Q06 expected=D03 baseline=None expanded=D03 Q07 expected=None baseline=None expanded=None Q08 expected=None baseline=None expanded=None baseline: 5/8 failed=['Q02', 'Q04', 'Q06'] expanded: 8/8 failed=[] 추가진단: 카페 몇 시에 문을 열어? => D01 (정답 None; 카페 자료가 없습니다.) 이 실패를 고쳐 주세요. 운영시간 관련 말만 보고 다른 시설의 영업시간까지 답하면 안 됩니다. 제공된 문서 범위를 넘은 대상은 보류하고, 기존8개 질문도 유지하세요. 문자열 전체 질문을 외우는 예외는 금지합니다. 변경 이유를 쉬운 한국어 3문장, 변경된 ALIASES와 함수만 제공하세요. 향후 처음 보는 표현에서 놓칠 수 있는 한계도 표시하세요. 실행했다고 주장하지마세요. 도구나파일접근 금지.
완성 예제와 해설 실제 두 번째 응답의 코드입니다. 원래 별칭은 유지하고, 자료에 없는 시설을 가리키면 보류하는 검사를 추가했습니다.
코드 예시# 이 도서관 자료에 없는 시설을 가리키는 말. 질문에 있으면 별칭이 맞아도 답하지 않고 보류한다. OUT_OF_SCOPE_FACILITIES = ( "카페", "커피숍", "식당", "매점", "편의점", "주차", "서점", "은행", "병원", "약국", "수영장", "체육관", "박물관", "영화관", "우체국", ) def search_expanded(question: str) -> Optional[str]: if any(facility in question for facility in OUT_OF_SCOPE_FACILITIES): return None return _best_doc(question, lambda d: d["tags"] + ALIASES.get(d["id"], ()))처음 보는 질문을 꺼내고, 틀린 결과를 다시 고치기
수정할 때 보지 않은 H01~H04를 꺼냈습니다. 폐관 시각, 스터디 공간, 출력 가격은 각각 맞는 자료를 찾았지만 “직원 전용 출입 몇 시예요?”에는 공개 운영시간 D01을 연결했습니다. 확장 검색의 첫 새 자료 점수는 3/4였습니다. 직원 문서를 검색에서 제외한 덕분에 비공개 문구가 노출되지는 않았지만, 다른 대상의 공개 정보를 답처럼 고른 문제는 남은 것입니다.
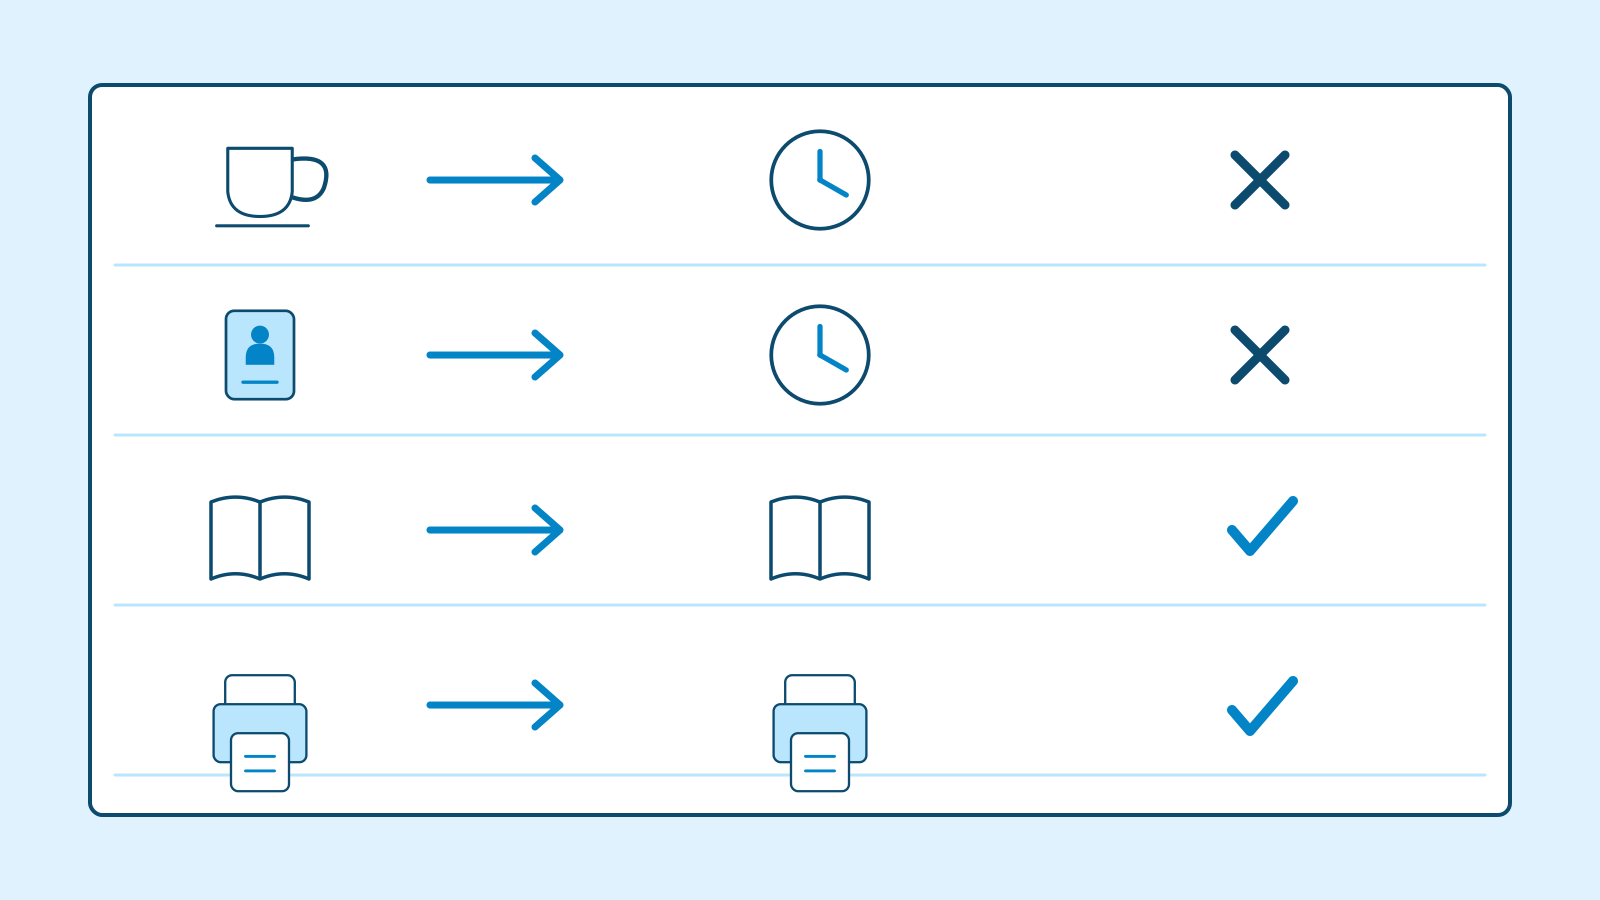
그림: 카페와 직원 질문에 도서관 운영시간을 붙인 오류를 책·인쇄의 올바른 근거 선택과 비교합니다 · AI Ping 이 실패도 같은 대화에 전달했습니다. “직원 문서를 제외했는데 왜 틀렸나”를 설명하면 접근 대상의 검사와 문서 목록 필터가 다른 일이라는 점이 드러납니다. Claude는 직원·스태프·관계자·관리자라는 대상을 나타내는 말이 있으면 보류하는 검사를 덧붙였습니다. 편집자는 이 세 번째 응답의 상수와 함수를 앞 코드에 합쳤고 기존 여덟 문제와 카페 진단을 다시 확인했습니다.
여기서 점수 표의 이름을 바꿔야 합니다. H01~H04는 처음에는 새 평가 자료였지만, 지금은 AI에게 오류를 보여 주고 수정에 사용했습니다. 따라서 수정 후의 4/4는 회귀 검사 결과입니다. 회귀 검사는 “고치면서 이전 동작을 망가뜨리지 않았나”를 보는 재확인입니다. 같은 네 문제를 계속 새 평가라고 부르면 실제로는 익숙해진 자료의 점수를 일반화 성능처럼 설명하게 됩니다.
완성한 규칙을 고정한 뒤 F01~F04를 따로 실행했습니다. 프린터 가격, 음료 허용, 은행 운영시간, 모임 예약 인원 질문입니다. 이 네 질문은 세 차례의 수정 요청에 보내지 않았습니다. 최종 확장 검색은 4/4, 기본 검색은 2/4였습니다. 마지막 결과 역시 작고 편집된 사례의 기록이며, 실제 이용자 질문 전체를 대표한다고 말할 수 없습니다. 독자가 같은 파일을 돌려 확인할 수 있는 수치로 남깁니다.
완성 코드에 남은 제약도 구체적입니다. 직원에게 운영시간을 물으면 되는지 묻는 평범한 질문도 “직원”이라는 단어 때문에 보류할 수 있습니다. 철자 오류, 복합 질문, 자료 업데이트와 같은 상황도 이번 네 문제로 검증되지 않았습니다. 서비스에 적용하려면 더 다양한 질문과 답의 의미 검토가 필요합니다. 이 수업의 완료 결과물은 무결한 검색 서비스가 아니라, AI와 코드를 만들고 실패를 재현하며 평가 자료를 관리하는 실행 가능한 연습입니다.
편집자가 실제 실행한 검색 비교: 수정에 쓴 자료와 새 자료를 구분합니다 자료 기본 검색 최종 확장 검색 해석 개발 Q01~Q08 5/8 8/8 코드 작성과 수정에 사용 카페 진단 X01 1/1 1/1 첫 버전의 실패를 고친 재확인 H01~H04 1/4 4/4 중간 확장 버전 3/4 → 수정 후 회귀 검사 새 F01~F04 2/4 4/4 세 수정 요청에 넣지 않은 마지막 확인 프롬프트 예시 실제 새 검사에서 “직원 전용 출입 몇 시예요?”의 정답은 None인데 D01이 나왔습니다. 비공개 문서 자체는 검색에서 제외돼 있습니다. 질문의 대상도 확인해 보류하도록 search_expanded만 수정해 주세요. 기존 별칭과 시설 제외 규칙, 개발 여덟 문제는 유지해 주세요. 이 네 문제는 수정에 사용했으므로 이후에는 회귀 검사로 표시합니다. 실행하지 않은 결과를 실행했다고 쓰지 마세요.
완성 예제와 해설 실제 세 번째 응답에서 받은 추가 검사입니다. 위 요청문은 읽기 편하게 정리한 같은 수정 요구이며 실행 당시 원문은 대화 파일에 보존했습니다.
코드 예시# 직원 등 내부 대상을 가리키는 말. 공개 문서는 일반 이용자용이므로 이런 대상의 질문은 보류한다. STAFF_AUDIENCE_MARKERS = ("직원", "스태프", "관계자", "관리자") def search_expanded(question: str) -> Optional[str]: if any(facility in question for facility in OUT_OF_SCOPE_FACILITIES): return None if any(marker in question for marker in STAFF_AUDIENCE_MARKERS): return None return _best_doc(question, lambda d: d["tags"] + ALIASES.get(d["id"], ()))완성 파일을 실행하고 AI가 바꾼 부분을 설명하기
완성 파일 retrieval-evaluation-lab.py에는 첫 응답의 문서와 함수, 두 차례의 수정, 편집자가 추가한 새 질문과 실행 부분이 들어 있습니다. AI가 쓴 원문을 몰래 고쳐 “처음부터 받은 답”처럼 보여 주지 않습니다. 대화 원문에는 받은 코드가 그대로 있고 완성 파일의 머리말에는 편집자가 패치를 합치고 평가 묶음을 추가했다고 적었습니다. 무엇을 복사했고 무엇을 수정했는지 확인하는 것 자체가 AI 코딩 도우미 활용의 일부입니다.
다운로드한 파일을 새 폴더에 저장하고 python3 retrieval-evaluation-lab.py를 실행합니다. 출력의 development, diagnostic, regression, fresh는 바로 앞 절에서 설명한 네 자료 묶음입니다. 각 줄에는 통과 수와 실패 질문 번호가 나옵니다. 출력이 다르면 숫자를 교재에 맞춰 고치지 말고 사용한 파일과 Python 버전, 실제 오류를 기록합니다. 그 기록을 AI에 다시 주며 “어느 함수에서 차이가 났는지 먼저 설명해 달라”고 요청할 수 있습니다.
최종 코드에서 입력이 흐르는 순서를 말로 풀어 봅니다. 먼저 질문에 자료 밖 시설이나 직원 대상이 있는지 확인합니다. 다음에는 공개 문서만 남기고 태그와 별칭을 센 뒤 가장 높은 양의 점수를 가진 문서를 돌려줍니다. 모두 영점이면 None입니다. 이런 설명을 할 수 있으면 코드 전체를 외우지 않아도 AI가 잘못 바꾼 부분을 찾는 출발점이 생깁니다. “검사가 끝나기 전에 번호를 돌려주는 줄” 같은 위치도 질문할 수 있습니다.
AI에게 후속 작업을 부탁할 때는 현재 파일과 함께 유지할 결과를 적습니다. 예를 들어 함수 이름을 정리하되 기존 열일곱 개 확인을 유지하라고 요청할 수 있습니다. 여덟 개발 문제, 한 진단, 네 회귀, 네 새 확인을 더하면 열일곱 개입니다. 그러나 코드를 다시 수정하는 순간 마지막 네 문제도 개발 과정에서 본 자료가 됩니다. 이후 변경의 일반화는 또 다른 질문으로 확인해야 한다는 기록을 남깁니다.
이 과정에서 AI를 쓰는 이유는 코드 한 파일을 빨리 얻는 데만 있지 않습니다. 사람이 실패 상황을 정확히 제시하면 AI가 가설과 수정 후보를 제안하고, 사람이 실행해 확인한 결과로 다음 요청을 정할 수 있습니다. 요청·응답·실행·수정이 이어져야 결과물의 근거가 남습니다. 다음에 다른 문서 집합을 쓰더라도 원문 보존, 접근 조건, 반환값, 비교 기준, 새 평가 자료라는 구조는 그대로 재사용할 수 있습니다.
완성 Python 프로그램 파일 내용 retrieval-evaluation-lab.py Python 3 · offline · 17 checks 완성 예제와 해설 편집자 최종 실행 결과입니다. 이 결과는 문자열 검색 프로그램의 동작이며 AI 모델의 전체 정확도가 아닙니다.
코드 예시development baseline: 5/8 development expanded: 8/8 diagnostic baseline: 1/1 diagnostic expanded: 1/1 regression baseline: 1/4 regression expanded: 4/4 fresh baseline: 2/4 fresh expanded: 4/4
3 / 4
확인과 해설
AI에 어떤 요청을 할지 생각한 뒤 해설을 읽으세요. 답안 작성·제출·외부 AI 실행은 선택입니다.
정답을 맞혀야 다음 수업으로 가는 시험이 아닙니다. 해설을 읽고 이해하는 데 사용하세요.
Q1기본 검색 5/8, 확장 검색 8/8입니다. “Claude가 실제 이용자 질문을 100% 정확히 처리했다”는 설명을 어떻게 고칠까요?
내 생각 적기 (선택)
작성 내용은 전송되지 않으며, 페이지를 떠나거나 새로고침하면 사라져요. 필요한 내용은 복사해 두세요.
답과 해설 보기
편집자가 만든 개발 질문 여덟 개에서 로컬 확장 검색이 8/8을 기록했다고 씁니다. AI는 코드를 제안했고 실행은 문자열 규칙이 수행했습니다. 가상 자료의 작은 확인이므로 실제 이용자 전체나 모델의 일반 성능을 뜻하지 않습니다.
직접 비교한 표시이며 자동 채점은 아니에요.
Q2새 질문 H04의 실패를 AI에게 보여 주고 수정한 뒤 H01~H04가 4/4입니다. 이 점수를 어떤 이름으로 기록하나요?
내 생각 적기 (선택)
작성 내용은 전송되지 않으며, 페이지를 떠나거나 새로고침하면 사라져요. 필요한 내용은 복사해 두세요.
답과 해설 보기
회귀 검사라고 기록합니다. 네 문제는 이제 수정 과정에서 본 자료이므로 새로운 평가가 아닙니다. 변경 뒤 처음 볼 질문은 별도로 남겨 다시 확인해야 합니다.
직접 비교한 표시이며 자동 채점은 아니에요.
Q3“카페 몇 시에 문을 열어?”가 D01을 반환했습니다. AI에게 보낼 추가 요청에는 무엇을 넣어야 하나요?
내 생각 적기 (선택)
작성 내용은 전송되지 않으며, 페이지를 떠나거나 새로고침하면 사라져요. 필요한 내용은 복사해 두세요.
답과 해설 보기
실패 입력, 실제 결과 D01, 기대 결과 None과 카페 자료가 없다는 근거를 줍니다. 기존 여덟 질문과 공개 문서 필터를 유지할 조건도 적습니다. 문장 전체를 외우는 예외보다 잘못 연결된 원인을 고치도록 요청합니다.
직접 비교한 표시이며 자동 채점은 아니에요.
Q4새 D07은 “택배는 안내 데스크에서 당일 수령”만 말합니다. “보관함 비밀번호는?”을 D07로 연결해도 될까요?
내 생각 적기 (선택)
작성 내용은 전송되지 않으며, 페이지를 떠나거나 새로고침하면 사라져요. 필요한 내용은 복사해 두세요.
답과 해설 보기
비밀번호는 제공되지 않았으므로 보류합니다. 이는 연습용으로 만든 새 자료이며 실제 기관 안내가 아닙니다. 택배라는 주제가 같아도 요청한 정보가 근거에 있는지 따로 확인해야 합니다.
직접 비교한 표시이며 자동 채점은 아니에요.
자주 하는 실수
- AI가 예상한 출력을 직접 실행한 결과처럼 기록하기
- 처음 보는 문제를 수정 요청에 넣은 뒤에도 계속 새 평가라고 부르기
- 근거 문서 번호가 맞으면 답변 내용도 모두 맞다고 판단하기
- 별칭 목록으로 만든 작은 검색 점수를 AI 모델 전체의 정확도로 소개하기
나의 학습 기록
완료 표시는 선택이에요. 수업을 마쳤다고 판단되면 직접 표시하세요. 표시하지 않아도 다음 수업으로 갈 수 있어요.
완료 기록은 이 브라우저에 저장돼요.
4 / 4
내 업무에 적용하기
새 자료가 주어지면 활용 순서와 확인 기준을 어떻게 바꿀지 생각해 보세요. 외부 도구를 직접 써 보는 것은 선택입니다.
직접 해 보기: 새 자료를 넣어 AI에게 같은 과정을 요청하기
가상 안내 문서에 “택배 보관: 안내 데스크에서 당일 수령”이라는 공개 자료 D07을 추가한다고 해 봅시다. 먼저 기존 프로그램에 문서만 추가했을 때 무엇이 달라져야 하는지 적습니다. “택배 어디서 찾아요?”와 “보관함 비밀번호 알려 줘”는 비슷한 물건을 묻지만 근거가 다릅니다. 첫 질문은 당일 안내 데스크 수령으로 이어질 수 있고 두 번째는 문서에 비밀번호가 없어 보류해야 합니다. 문서를 만들며 존재하지 않는 비밀번호까지 답에 넣지 않습니다.
AI에게는 D07 원문과 현재 함수, 새로 기대하는 동작을 줍니다. “택배 관련 질문을 전부 D07로 보내라”는 요청은 너무 넓습니다. 그 대신 이 문서로 확인할 수 있는 수령 장소와 기한을 찾고, 제공하지 않은 정보는 보류하도록 요청합니다. AI가 새 별칭을 제안하면 어떤 질문이 잘못 연결될지 반대 예를 먼저 생각합니다. 입력에 같은 말이 있다고 같은 답을 할 수 있는지 원문에 대조하는 연습입니다.
직접 AI를 실행하지 않는 독자는 완성 요청문과 위 두 질문의 기대 결과만 설명해도 됩니다. “D07에 비밀번호가 없으므로 None으로 남긴다”는 이유까지 말해 보세요. 실행하는 독자는 첫 답을 저장하고 코드 실행 결과를 따로 기록합니다. 실패가 나오면 입력·실제 값·기대 값·근거를 같은 대화에 전달해 수정합니다. AI가 스스로 “테스트 완료”라고 썼다면 어떤 명령과 출력이 있는지 구분합니다.
검증용 질문도 새로 만듭니다. 수정에 쓴 “택배 어디서 찾아요?”를 그대로 다시 맞힌 결과는 회귀 확인입니다. 수정 뒤 처음 꺼낼 질문에는 원문으로 답할 수 있는 경우, 원문에 없는 경우, 직원 대상처럼 접근 조건이 다른 경우를 섞습니다. 문제 수가 작다면 작은 확인이라고 기록합니다. 교재에서 본 점수를 자신의 자료에 그대로 옮기거나 전체 고객의 성능 지표로 제시하지 않습니다.
완료 결과물은 세 파일이나 세 개의 메모로 정리할 수 있습니다. 첫째는 원문과 기대 동작, 둘째는 실제 AI 대화와 사람이 실행한 출력, 셋째는 수정한 코드와 남은 한계입니다. 이 셋을 함께 설명하면 “AI가 코드를 만들어 줬다”에서 더 나아가 어떤 요청이 어떤 수정을 만들었는지 보여 줄 수 있습니다. 다음 수업에서는 같은 방식으로 AI가 제안한 도구 요청을 검사하고 실패 뒤 다시 시도하는 과정을 배웁니다.
요청과 실제 응답 원문 파일 내용 retrieval-evaluation-lab-conversation.txt Exact recorded Korean conversation
직접 적어 보기 (선택)
요청문이나 이해한 내용을 기록하고 싶을 때만 열어 사용하세요. 이 입력란은 AI에 연결되지 않은 메모장입니다.
작성 내용은 전송되지 않으며, 페이지를 떠나거나 새로고침하면 사라져요. 필요한 내용은 복사해 두세요.
참고 자료
- Define success criteria and build evaluations — Anthropic
- unittest — Unit testing framework — Python Software Foundation