내 서버에서 코딩·문서 작업… Nanbeige 33B 가중치 공개
3줄 요약
- 코딩·사무용 모델과 추가 학습용 기본 모델을 함께 공개했다.
- 최대 52만 4,288토큰 문맥을 지원하며 가중치는 BF16 형식이다.
- 두 모델은 Apache 2.0 라이선스로 공개됐으며 재배포 고지 조건이 적용된다.

남베이거(Nanbeige) 연구팀이 코딩과 사무 작업을 수행하는 330억 파라미터 AI 모델 ‘Nanbeige4.3-33B’의 가중치를 허깅페이스에 공개했다. 10월 25일 갱신한 공식 모델 카드에는 비슷한 크기의 공개 모델과 비교한 작업 평가가 실렸다. 개발자는 모델을 자체 서버에 올려 코드와 업무 문서를 다루는 에이전트의 기반으로 쓸 수 있다.
이번 공개에는 대화·도구 사용에 맞춰 조정한 모델과 추가 학습의 출발점인 기본 모델이 함께 포함됐다. 조직이 자기 업무에 맞는 AI를 만들 때 바로 작업에 투입할 모델과 자체 데이터로 다시 훈련할 모델을 고를 수 있게 됐다. 기본 모델 카드도 범용 에이전트와 특정 분야 에이전트를 만드는 후속 학습을 용도로 명시했다.
다만 공개된 대화 템플릿의 입력 처리는 텍스트 중심이다. 사진·영상·오디오가 들어오면 해당 매체를 직접 처리할 수 없다는 안내를 넣도록 돼 있다. 스프레드시트나 스캔 문서를 쓰는 에이전트에서는 외부 도구로 내용을 읽어 텍스트를 모델에 전달하는 단계가 필요하다. 작업용 모델은 도구 이름과 인자를 받아 호출을 요청하고, 도구가 반환한 내용을 다음 응답의 재료로 쓴다.
연구팀의 비교에서 Nanbeige4.3-33B는 터미널에서 명령을 실행하며 과제를 푸는 Terminal-Bench 2.1에서 80.9점을 기록했다. 비교 대상 Qwen3.8-27B는 73.0점이었다. 사무 작업 평가인 JobBench 점수는 각각 44.8점과 34.5점이었다. 연구팀은 비교 모델마다 가장 높은 추론 설정을 적용하고, 같은 평가 안에서는 실행 조건과 평가 도구를 맞췄다고 설명했다.
JobBench는 여러 자료를 읽고 결과물을 만드는 일을 다룬다. 현재 공개 데이터의 기본 평가 묶음은 35개 직업에 걸친 65개 과제로 구성돼 있다. 각 과제에는 요청문, 참고 파일, 가중치가 있는 채점 기준이 붙는다. 일부 과제는 필요한 자료를 검색으로 찾아야 한다. 자료 유형에도 차이가 있어 표의 수치와 문서의 설명을 함께 읽어야 한다.
이 평가를 만든 연구진은 5월 논문에서 직업 종사자가 AI에 위임하고 싶어 하는 업무를 과제 선정의 출발점으로 삼았다고 밝혔다. 논문이 설명한 채점 방식은 연결된 세부 기준을 모두 충족했을 때 해당 묶음의 점수를 준다. 예컨대 맞는 수치를 찾았어도 결론에 이르는 판단이 틀리면 그 묶음에서 점수를 얻지 못한다. 논문 속 기자 과제는 여러 해의 수질 표와 공공 지침을 대조해 기준치를 넘긴 지역을 찾고 기사 자료를 만드는 일이었다. 새 모델의 점수는 이렇게 정해진 자료와 채점 기준에 따른 업무 시험 결과다.
긴 문맥과 추가 학습에 필요한 서버 자원
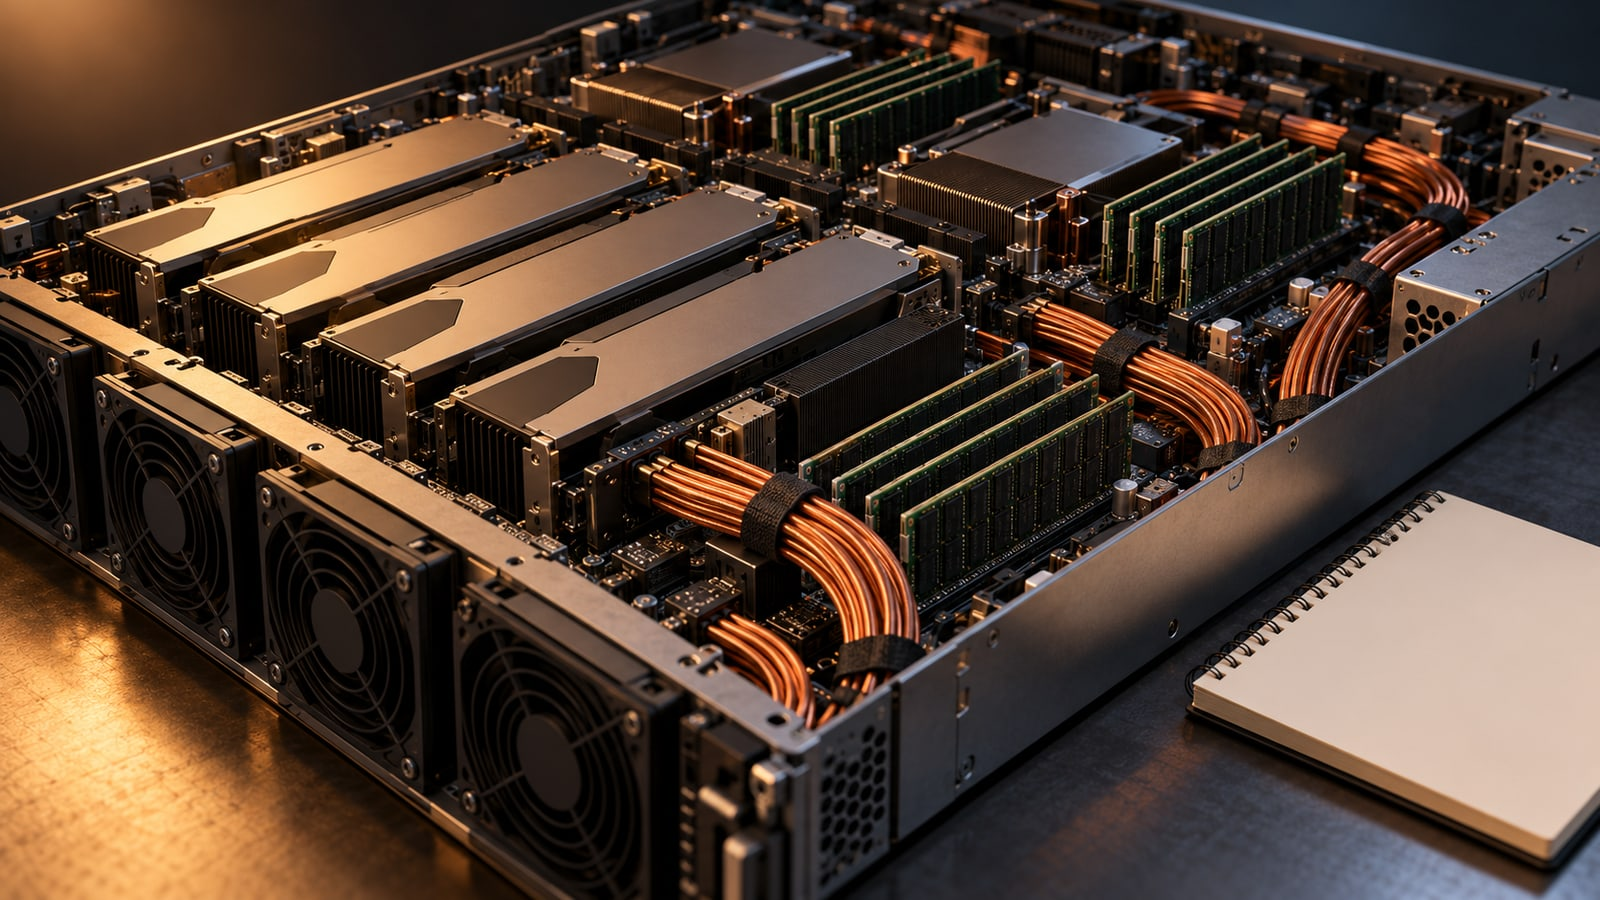
공개 설정에서 작업용 모델의 최대 문맥 길이는 52만 4,288토큰이다. 허깅페이스에 표시된 정확한 파라미터 수는 331억 1,897만 7,024개이며 가중치 형식은 BF16이다. 숫자 하나를 2바이트로 계산하면 가중치만 약 662억 바이트, 십진 단위로 66.2GB다. 실제 실행에는 대화 기록을 보관하는 공간과 중간 계산에 쓸 메모리가 추가로 필요하다.
추가 학습 경로는 NVIDIA의 NeMo AutoModel 문서에서도 확인된다. 현재 Nightly 문서는 이 모델을 기본 구현으로 읽어 들이는 기능과 두 가지 학습 예제를 안내한다. 전체 가중치를 학습하는 예제는 H100 8개가 장착된 서버 두 대를 사용한다. LoRA 방식의 예제는 GPU 8개를 갖춘 서버 한 대를 사용한다.
NVIDIA가 H100 80GB에서 100단계씩 실행한 기록에 따르면 전체 학습 예제의 단계당 시간은 약 27초, LoRA 예제는 약 36초였다. 이 기록은 해당 구성의 학습 시간과 메모리를 보여 준다. 공개된 손실 값은 학습 진행을 측정한 값이다.
기본 모델을 선택할 때는 문맥 설정에도 차이가 있다. NVIDIA 문서가 확인한 기본 모델의 최대 위치 수는 13만 1,072개다. 별도로 공개한 기본 모델 카드에는 지식·수학·코딩 등 8개 평가에서 Gemma4-31B-Base와 비교한 결과가 담겼다. 연구팀이 공개한 GPQA 점수는 각각 62.0점과 41.5점이었다. 이 결과는 추가 학습 전 기반 모델끼리의 비교다.
두 모델의 카드는 라이선스를 Apache 2.0으로 표시한다. 이 라이선스는 조건에 따라 복제·수정·배포를 허용하며, 재배포할 때 라이선스 사본과 관련 고지를 유지하고 수정한 파일에 변경 사실을 밝혀야 한다. 공개 모델을 변형해 배포하는 경우에도 이러한 조건이 적용된다. 라이선스는 관련 저작권·특허·출처 고지도 보존하도록 정하고 있다. 원래 배포물에 NOTICE 파일이 포함됐다면 그 고지를 읽을 수 있는 형태로 함께 전달해야 한다.
출처
- Nanbeige4.3-33B — model card and evaluations — Nanbeige LLM Lab
- Nanbeige4.3-33B-Base — base checkpoint and evaluation — Nanbeige LLM Lab
- Published model configuration — Nanbeige LLM Lab / Hugging Face
- Public model metadata and parameter inventory — Hugging Face
- Nanbeige4.3-33B — NeMo AutoModel Nightly documentation — NVIDIA
- JobBench dataset — tasks and grading structure — JobBench researchers
- JobBench: Aligning Agent Work With Human Will — May 2026 — JobBench researchers
- Apache License, Version 2.0 — Apache Software Foundation
- Published conversation template — text and tool input handling — Nanbeige LLM Lab