NVIDIA, 짧게 답하는 Bolt E4B 가중치 공개
3줄 요약
- Q4_K_M 파일을 공개했다.
- GPU 메모리는 작업별로 달랐다.
- 추론과 대화 모드를 따로 조절한다.
NVIDIA가 짧은 대화 응답에 맞춘 소형 언어 모델 ‘Nemotron 3.5 Bolt E4B 4GB’의 가중치를 공개했다. 모델 카드에 적힌 출시일은 10월 23일이다. Hugging Face와 NVIDIA의 빌드 플랫폼에서 같은 날 공개했다.
공개 저장소에는 Q4_K_M 방식으로 양자화한 GGUF 파일이 올라와 있다. 파일 목록에 표시된 크기는 6.18GB다. 제품명에 들어간 ‘4GB’와 다운로드 용량은 다르며, NVIDIA는 실행 중 GPU 메모리를 별도로 측정해 공개했다.
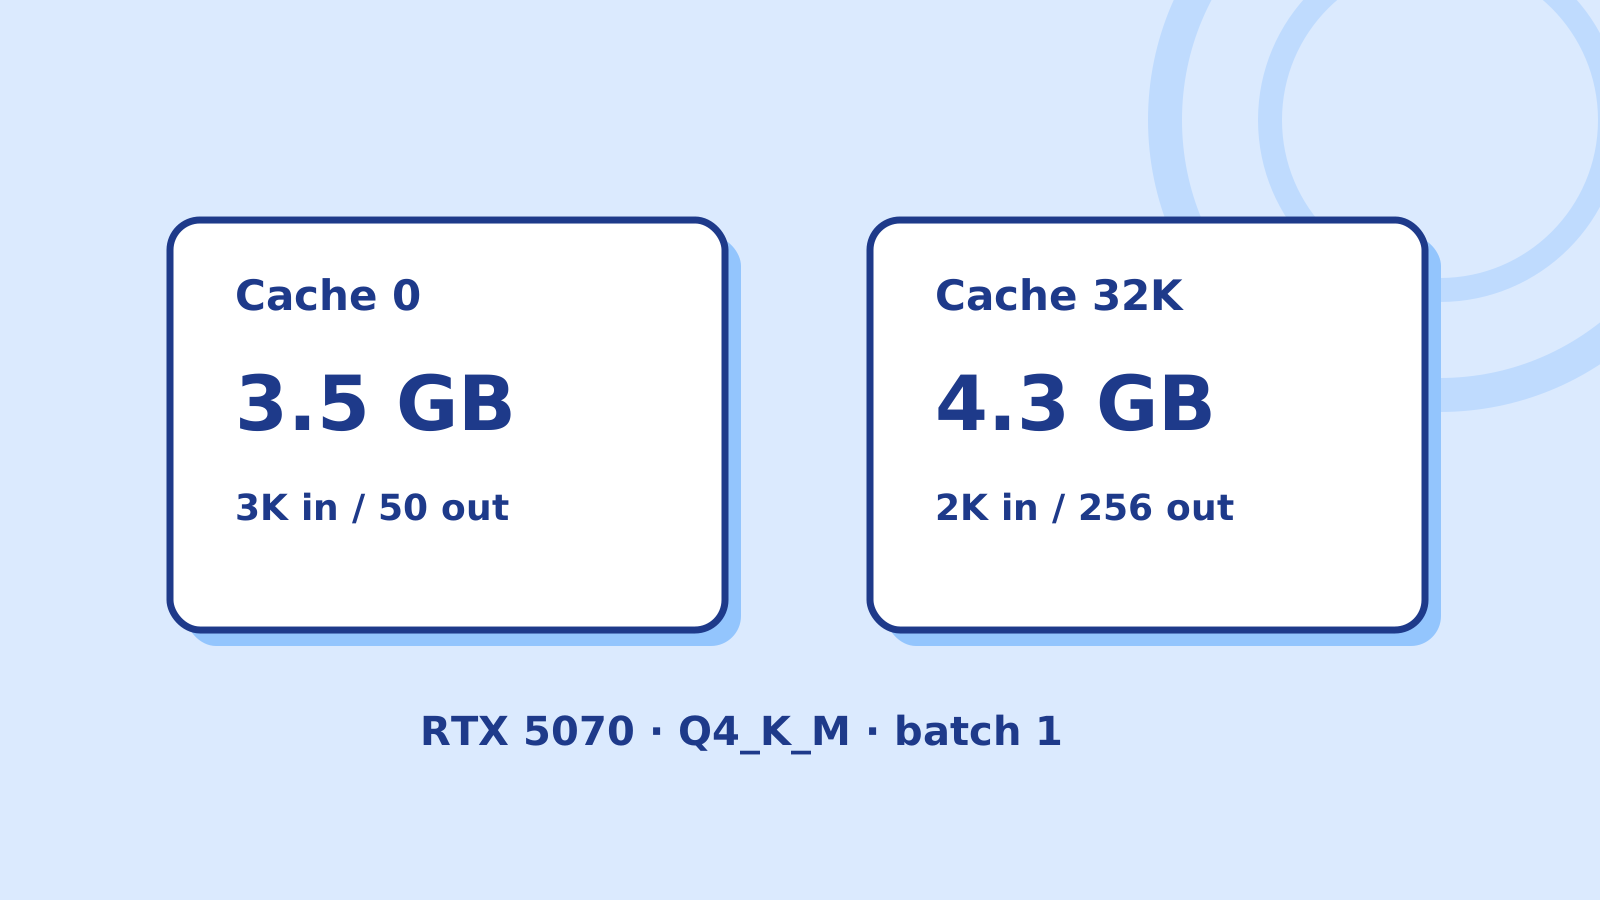
NVIDIA의 RTX 5070(12GB) 측정에서 새 입력 3,000토큰·출력 50토큰을 처리할 때 최대 GPU 메모리는 3.5GB였다. 3만2,000토큰을 캐시에 둔 채 새 입력 2,000토큰·출력 256토큰을 처리하면 4.3GB로 늘었다. Q4_K_M 모델을 llama.cpp의 CUDA 환경에서 한 번에 한 요청씩 실행한 결과다.
수치는 NVIDIA가 AIPerf로 측정했다. 목표 작업의 ‘약 4GB’는 모든 4GB 기기의 실행이나 음성 앱 전체의 메모리를 보장하지 않는다.
기반은 Gemma 4 E4B-it이며 전체 파라미터는 80억 개, 유효 파라미터는 40억 개다. 문맥은 최대 6만4,000토큰이다. 추론·대화 모드는 독립적으로 조절하며 도구 호출과 함께 쓴다. 런타임 한도로 추론이 문장 중간에 잘릴 수 있다.
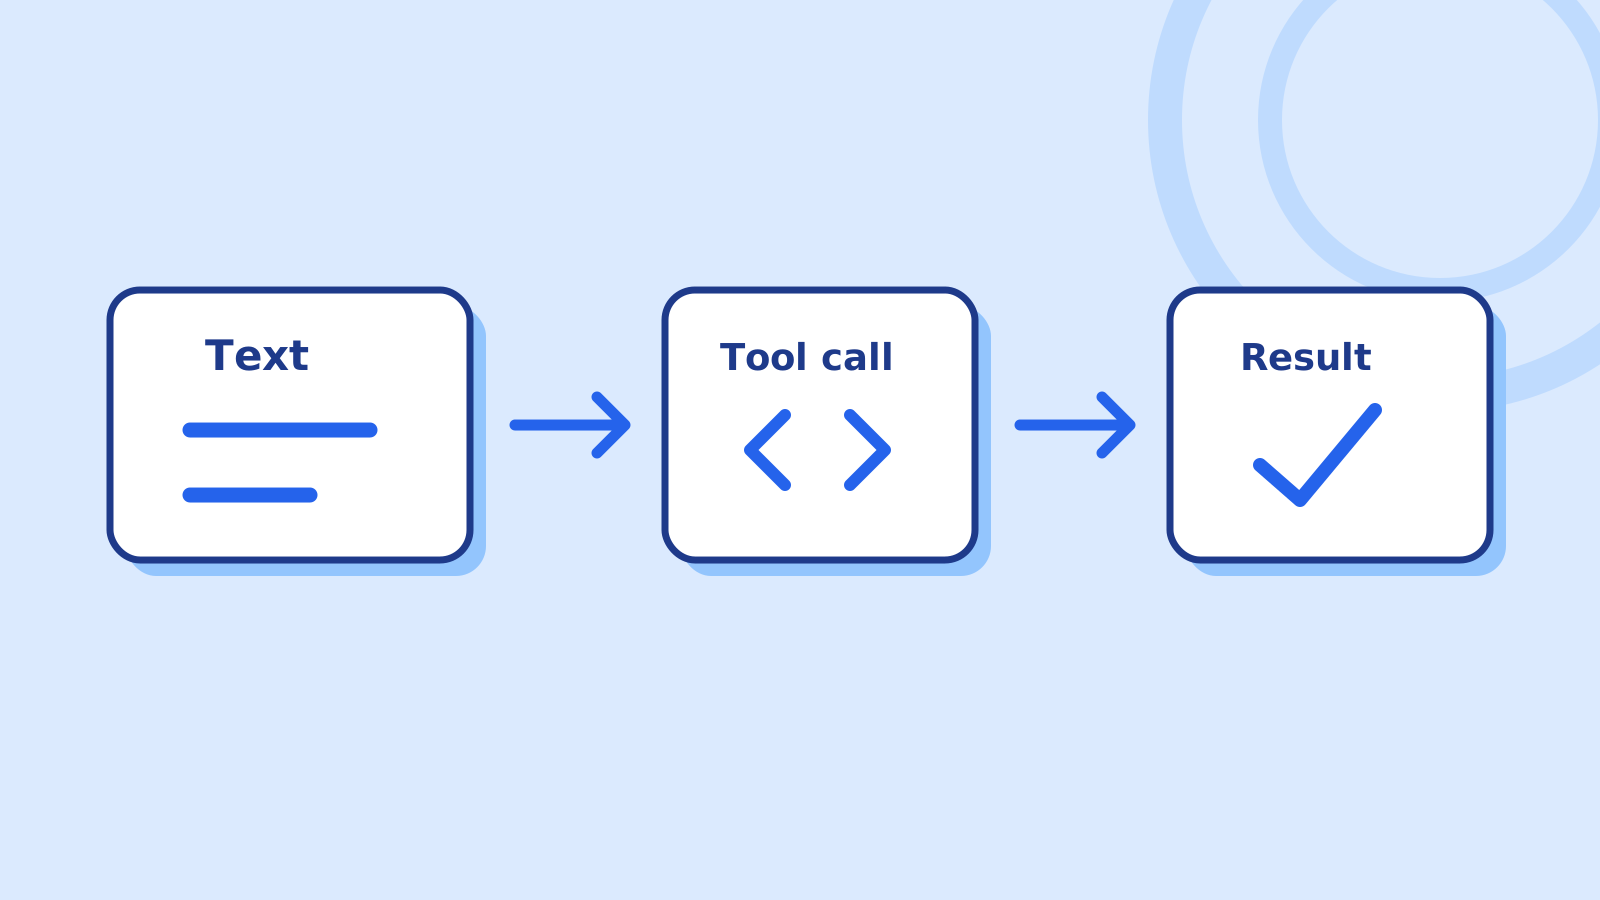
기술 보고서에 따르면 대화 모드는 짧게 답하고 서식을 줄이라는 시스템 지시를 추가한다. 템플릿은 설명 텍스트를 도구 호출·결과보다 먼저 놓아 실행에 앞서 행동을 설명하도록 했다.
NVIDIA는 지도 미세조정(SFT) 실험이 도구 사용을 개선했지만 대화 품질과 장황함을 악화시켜, 공개 모델의 후학습에서는 이 단계를 제외했다고 밝혔다.
영어만으로 후학습한 뒤 BF16 추론 모드의 한국어 MMLU-ProX 점수는 64.51로 기반 모델보다 1.77%포인트 낮아졌다. 보고서의 이 수치는 Q4_K_M 파일 측정값과 다르다.
도구를 정확하게 선택하는 능력에도 별도의 적용 조건이 붙는다. NVIDIA는 설명 문서에서 비신뢰 입력의 지시나 프롬프트 주입에 모델이 영향을 받을 수 있다고 명시했다. 악의적인 지시를 걸러 내는 장치와 데이터 필터링을 함께 쓰도록 안내하며, 통제가 없는 에이전트 시스템에서는 권한 범위 밖의 정보 접근이나 코드 실행으로 이어질 위험을 들었다.
모델에는 OpenMDW 1.1 라이선스를 적용했다. 해당 약관은 조건을 지키는 이용을 무료로 허용하고, 모델 자료 일부라도 재배포할 때는 라이선스 사본과 적용되는 저작권·출처 고지를 보존하도록 정했다. 생성된 출력의 이용·수정·공유에는 이 약관에 따른 추가 의무를 부과하지 않는다. 정확성을 보증하지 않는다는 조항도 포함했다.
출처
- NVIDIA Nemotron 3.5 Bolt E4B 4GB — NVIDIA Research
- NVIDIA-Nemotron-3.5-Bolt-E4B-4GB — model card — NVIDIA / Hugging Face
- Bolt E4B — published model files — NVIDIA / Hugging Face
- Nemotron 3.5 Bolt E4B 4GB: An Open and Efficient Small Language Model for Fast Conversational Agents — NVIDIA Research
- Bolt E4B — explainability — NVIDIA / Hugging Face
- OpenMDW License Agreement, version 1.1 — OpenMDW