애플 MLX, Mac Studio 4대로 8,160억 파라미터 모델 돌린다
3줄 요약
- 애플이 머신러닝 프레임워크 MLX 새 버전으로 Mac Studio 여러 대를 묶어 거대 모델을 돌리는 방법을 공개했습니다.
- Mac Studio 4대를 썬더볼트로 연결해 8,160억 파라미터의 오픈 모델 Muse Spark Open을 초당 36토큰이 넘는 속도로 실행했습니다.
- M5 Ultra는 이전 M3 Ultra보다 첫 토큰이 최대 4.6배 빨리 나오고, 최대 전력은 약 300W 수준입니다.
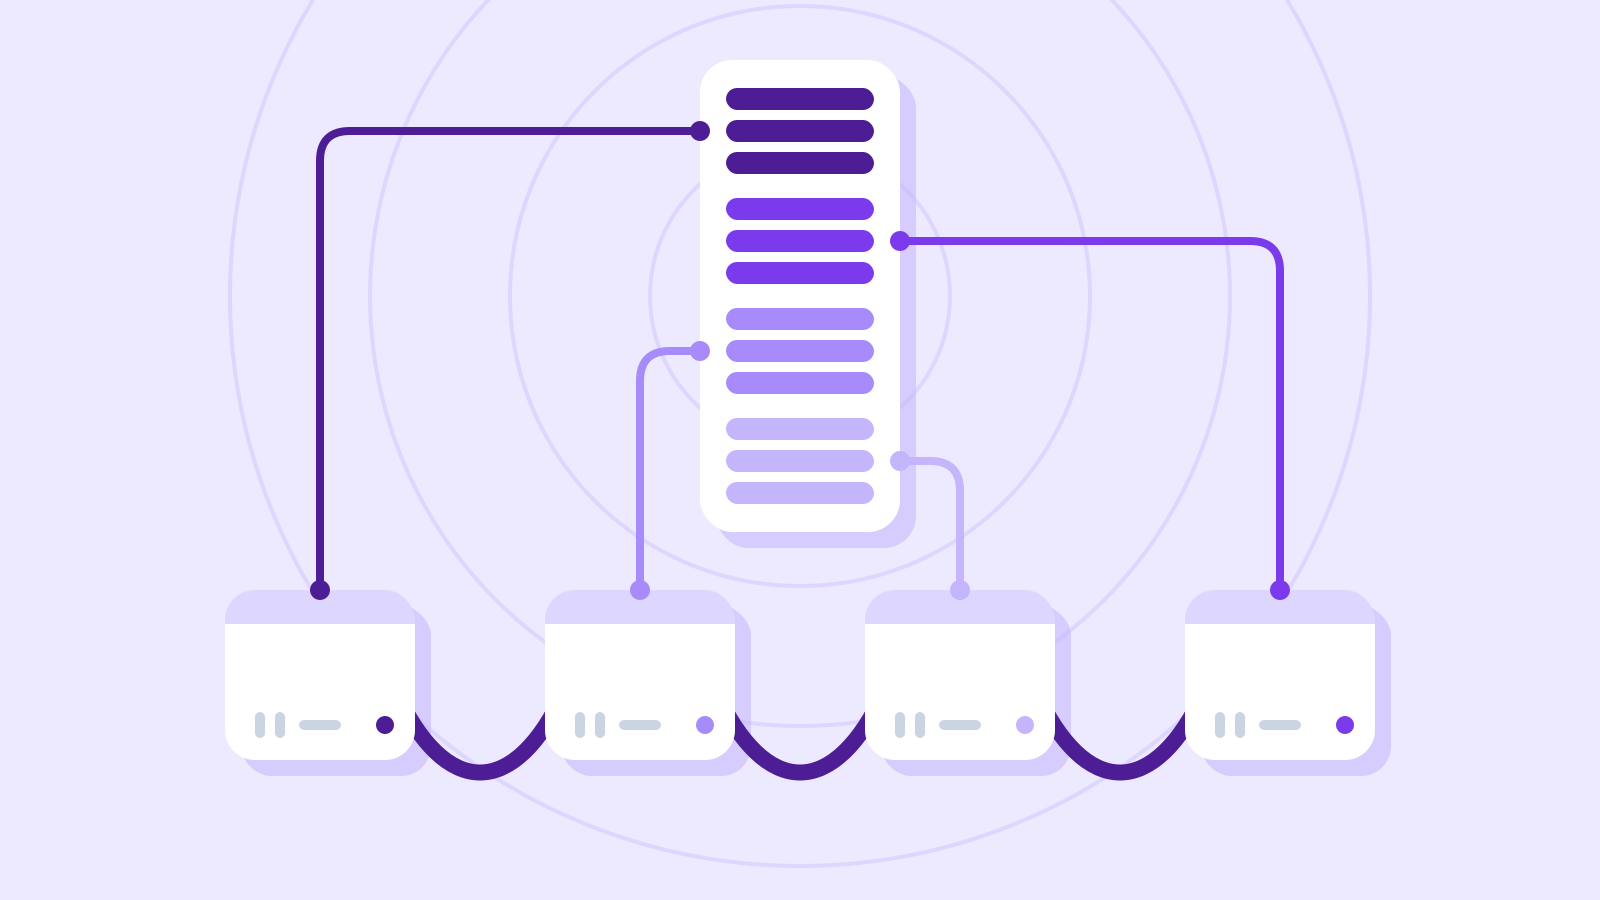
애플 머신러닝 연구팀은 오픈소스 프레임워크 MLX의 새 버전과 함께, Mac Studio에서 거대 언어 모델을 직접 돌리는 방법을 소개했습니다. Mac Studio 한 대는 통합 메모리를 최대 512GB까지 갖출 수 있고, 그보다 큰 모델은 여러 대를 썬더볼트 케이블로 연결해 나눠 실행합니다.
대표 사례는 Meta의 오픈 모델 Muse Spark Open입니다. 전체 8,160억 파라미터 중 420억 개가 활성화되는 MoE 모델로, 4비트(NVFP4)로 줄여도 약 493GB라 한 대에는 들어가지 않습니다. 애플은 M5 Ultra를 넣은 Mac Studio 4대로 모델을 나눠 초당 36.73토큰을 생성했고, 이는 사람의 평균 읽기 속도보다 훨씬 빠르다고 설명했습니다.
모델을 나누는 방법은 두 가지입니다. 층을 앞뒤로 나눠 차례로 처리하는 '파이프라인' 방식은 구현이 간단하고, 각 층을 폭으로 쪼개 여러 대가 동시에 계산하는 '텐서' 방식은 더 빠르지만 통신이 잦습니다. macOS 26.2에 들어간 썬더볼트 5 기반 저지연 통신(RDMA)과 MLX의 새 통신 기능 덕분에 텐서 방식에서도 속도를 낼 수 있었다는 설명입니다.
칩 세대 비교도 공개했습니다. M5 Ultra는 GPU의 신경망 가속기 덕분에 첫 토큰이 나오기까지의 시간이 M3 Ultra보다 최대 4.6배 짧았고, 메모리 대역폭(1.2TB/s)이 늘어 생성 속도는 1.6배 빨랐습니다. 최대 전력은 M3 Ultra 약 200W, M5 Ultra 약 300W였습니다. 수치는 애플이 고른 모델과 설정으로 측정한 결과입니다.
왜 중요한가
데이터센터에서나 돌리던 수천억 파라미터급 모델을 사무실 책상 위 컴퓨터 몇 대로 돌릴 수 있게 됐다는 점이 핵심입니다. 코드를 회사 밖으로 보내기 어려운 팀이 코딩 에이전트를 내부에서 쓰는 선택지가 넓어질 것으로 보입니다.
누구에게 중요한가
- 개발자
- mlx_lm.server로 로컬 서버를 띄우면 OpenCode 같은 코딩 에이전트에 바로 연결할 수 있습니다. 270억·1,280억 파라미터급 모델은 512GB Mac Studio 한 대에서도 돌아가니, 한 대 구성부터 시험해 보세요.
출처
- Local and Distributed Large LLM Inference with MLX and RDMA on Mac Studio — Apple Machine Learning Research