NVIDIA, 오픈 모델 'Nemotron 3.5' 공개… 서버부터 노트북까지
3줄 요약
- NVIDIA가 에이전트용 오픈 모델 'Nemotron 3.5 Super VL'과 PC·소형 기기용 'Bolt' 두 종을 공개했습니다.
- Super VL은 1,200억 파라미터로 이미지·문서도 이해하며, 자사 최대 추론 모델과 비슷한 정확도를 약 5분의 1 크기로 냈다고 NVIDIA는 밝혔습니다.
- Super VL과 Bolt 74B-A9B는 지금 Hugging Face 등에서 받을 수 있고, Bolt E4B는 10월 23일 나옵니다.
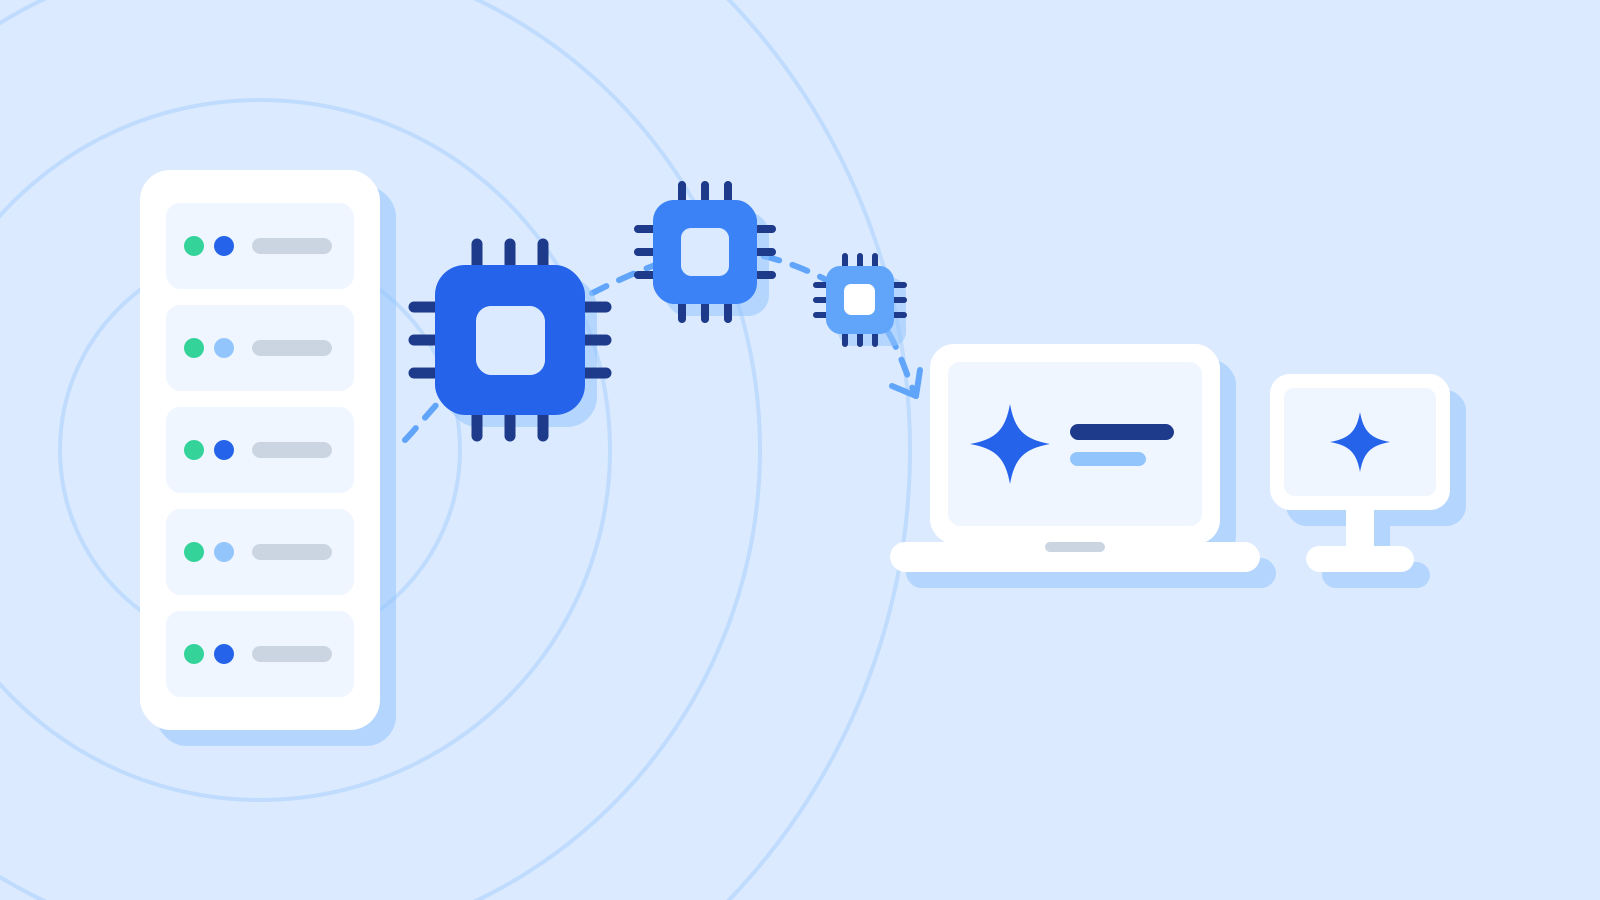
NVIDIA는 10월 15일 오픈 모델 Nemotron 3.5 Super VL과 함께, PC·소형 기기용 모델 Nemotron 3.5 Bolt 74B-A9B 24GB와 Bolt E4B 4GB를 공개했습니다. 큰 기업 서버부터 개인 PC, 작은 엣지 기기까지 에이전트를 돌리는 환경마다 맞는 오픈 모델을 고를 수 있게 했다는 설명입니다.
Super VL은 1,200억 파라미터 규모의 멀티모달 모델로 지시 따르기, 도구 사용, 여러 단계의 업무 흐름, 이미지·웹페이지·PDF 이해에 초점을 맞췄습니다. NVIDIA는 같은 급 오픈 모델 가운데 가장 빠르고 그다음 모델보다 5배 빠르다고 주장했습니다. 가중치뿐 아니라 학습 데이터셋과 학습 방법도 공개해, 기업이 자기 데이터로 추가 학습하고 자체 인프라에서 운영할 수 있습니다.
Bolt 74B-A9B는 모델을 작게 압축하는 2비트 양자화로 24GB 메모리 안에서 돌아가도록 만들어, RTX Spark 노트북이나 DGX Spark 같은 개인 장비에서 웹 조사, 글쓰기, 코드 디버깅 같은 일을 클라우드로 보내지 않고 맡길 수 있게 했습니다. llama.cpp, Ollama, LM Studio, vLLM 같은 실행 도구도 지원합니다. Bolt E4B 4GB는 음성 비서처럼 빠르게 대화하는 에이전트용입니다.
Atlassian, CrowdStrike, Perplexity, Salesforce 등이 Super VL을 자사 서비스에 넣거나 맞춤 학습하고 있다고 NVIDIA는 밝혔습니다. 다만 속도와 정확도 비교는 NVIDIA가 고른 벤치마크 기준이어서, 실제 업무 성능은 직접 확인해야 합니다.
왜 중요한가
같은 계열의 모델을 서버용부터 노트북용까지 크기별로 공개해, 기업이 데이터를 밖으로 보내지 않고 에이전트를 운영할 선택지가 늘었습니다. 칩 회사인 NVIDIA가 모델과 데이터, 학습 방법까지 공개하는 것은 자사 GPU 생태계를 넓히려는 전략으로 보입니다.